Qué son los sistemas de archivos distribuidos en la nube
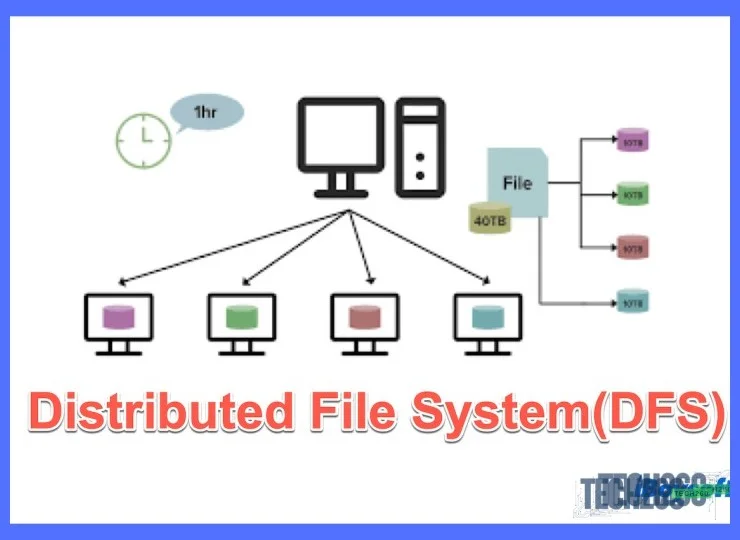
- Concepto y funcionamiento básico de un DFS en entornos cloud
- Nodos de almacenamiento y metadatos en la arquitectura distribuida
- Mecanismos de replicación y tolerancia a fallos en la nube
- Escalabilidad horizontal y acceso concurrente desde múltiples ubicaciones
- Comparativa entre Google Cloud Filestore y Amazon EFS
Un sistema de archivos distribuido en la nube es una infraestructura de almacenamiento que organiza y gestiona datos a través de múltiples servidores o nodos interconectados, presentando al usuario una vista unificada de archivos. A diferencia de un disco duro local o un servidor tradicional, estos sistemas fragmentan la información en bloques, los replican en distintos nodos para garantizar disponibilidad y permiten escalar horizontalmente añadiendo más capacidad sin interrumpir el servicio. En este artículo, explicaremos primero cómo se diferencian de los sistemas de almacenamiento en bloque y objeto, analizaremos casos de uso concretos para industrias como big data y streaming, y finalmente abordaremos los desafíos técnicos que presentan, como la latencia, la consistencia de datos y la tolerancia a fallos. (ver también: Qué son las bases de datos NoSQL y cuándo usarlas)
Concepto y funcionamiento básico de un DFS en entornos cloud
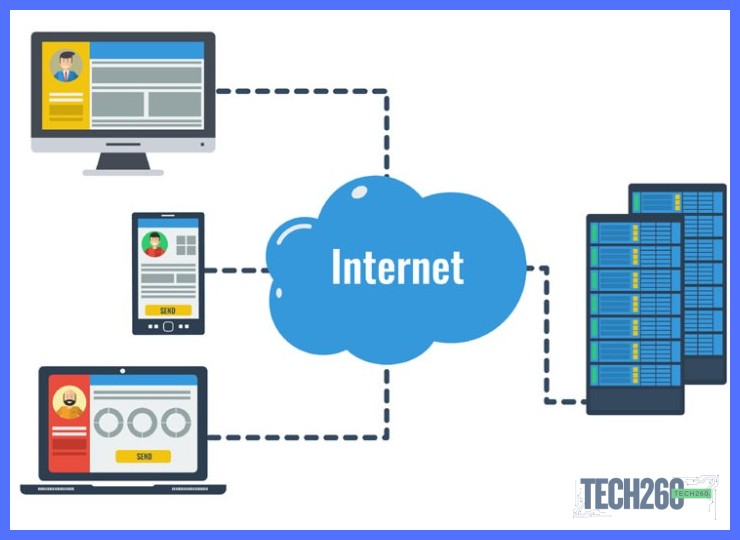
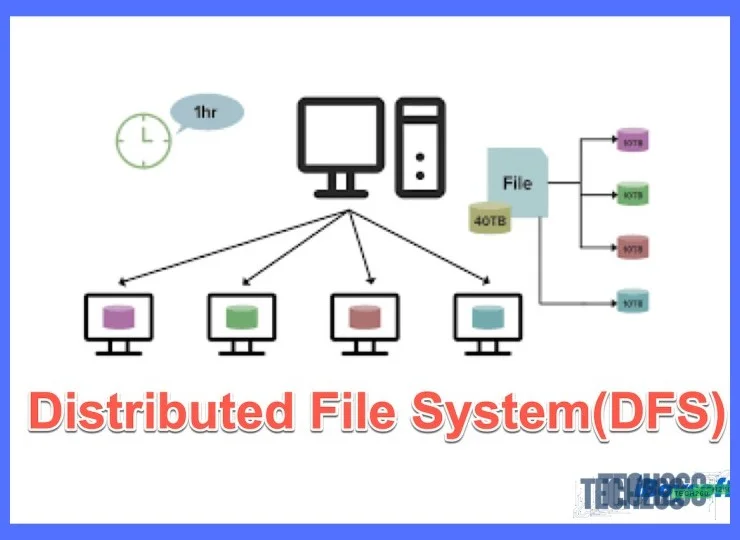
Un sistema de archivos distribuido (DFS) en entornos cloud es una capa de software que abstrae múltiples servidores de almacenamiento físico, presentándolos como un único espacio de nombres lógico y accesible desde cualquier nodo de la red. Su funcionamiento básico se basa en la fragmentación de archivos en bloques, que se replican y distribuyen entre varios nodos del clúster cloud. Un metadatoserver centralizado o descentralizado gestiona un índice que mapea cada bloque a su ubicación física, permitiendo que las operaciones de lectura y escritura se ejecuten en paralelo, lo que maximiza el rendimiento y la tolerancia a fallos.

Para entender este concepto, es clave notar que su diseño prioriza la escalabilidad horizontal: al agregar más nodos, la capacidad y el throughput aumentan de forma casi lineal. A diferencia de un NAS tradicional, un DFS cloud maneja automáticamente la replicación de datos (típicamente 3 copias) y la recuperación ante caídas de hardware. Ejemplos como HDFS o Amazon EFS ilustran cómo estos sistemas optimizan el acceso concurrente desde miles de instancias, garantizando consistencia eventual o fuerte según la configuración. Se trata, en esencia, de una infraestructura que combina distribución, replicación y un namespace unificado para ofrecer almacenamiento elástico y resistente.
Nodos de almacenamiento y metadatos en la arquitectura distribuida
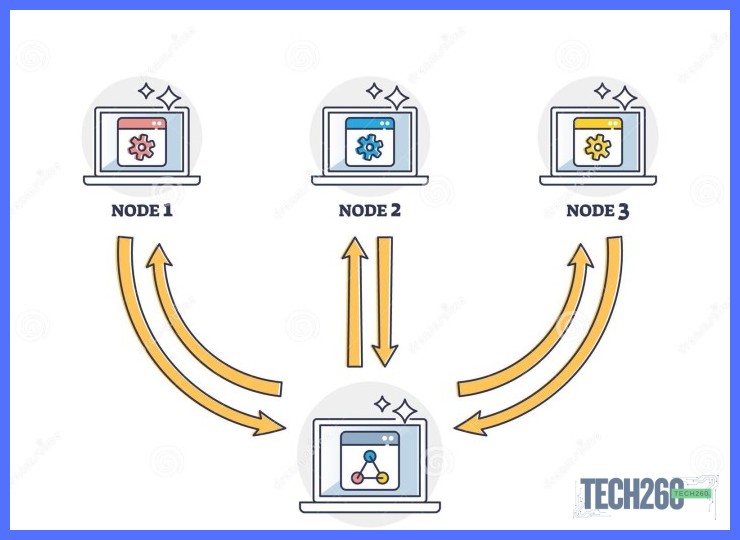
Los nodos de almacenamiento son los servidores físicos o virtuales que alojan los fragmentos de datos en un sistema de archivos distribuido. Los metadatos, por su parte, constituyen un índice centralizado que registra la ubicación exacta de cada fragmento, sus réplicas y permisos. Para entender cómo funcionan estos sistemas, es clave saber que esta separación entre datos y metadatos permite escalar horizontalmente: mientras los nodos de almacenamiento gestionan terabytes de información, el servidor de metadatos coordina las operaciones de lectura y escritura sin saturarse.
Un matiz importante es que los metadatos no siempre residen en un único punto. Arquitecturas modernas, como las basadas en consenso distribuido, replican los metadatos entre varios nodos para evitar puntos únicos de fallo. Esto introduce latencia adicional, pero garantiza consistencia incluso si falla un servidor. Además, los nodos de almacenamiento suelen agruparse en racks o zonas de disponibilidad, y el sistema replica automáticamente los fragmentos en nodos geográficamente separados. Al explorar esta arquitectura, se revela que balancea eficiencia, tolerancia a fallos y escalabilidad mediante esta división de responsabilidades.
Mecanismos de replicación y tolerancia a fallos en la nube
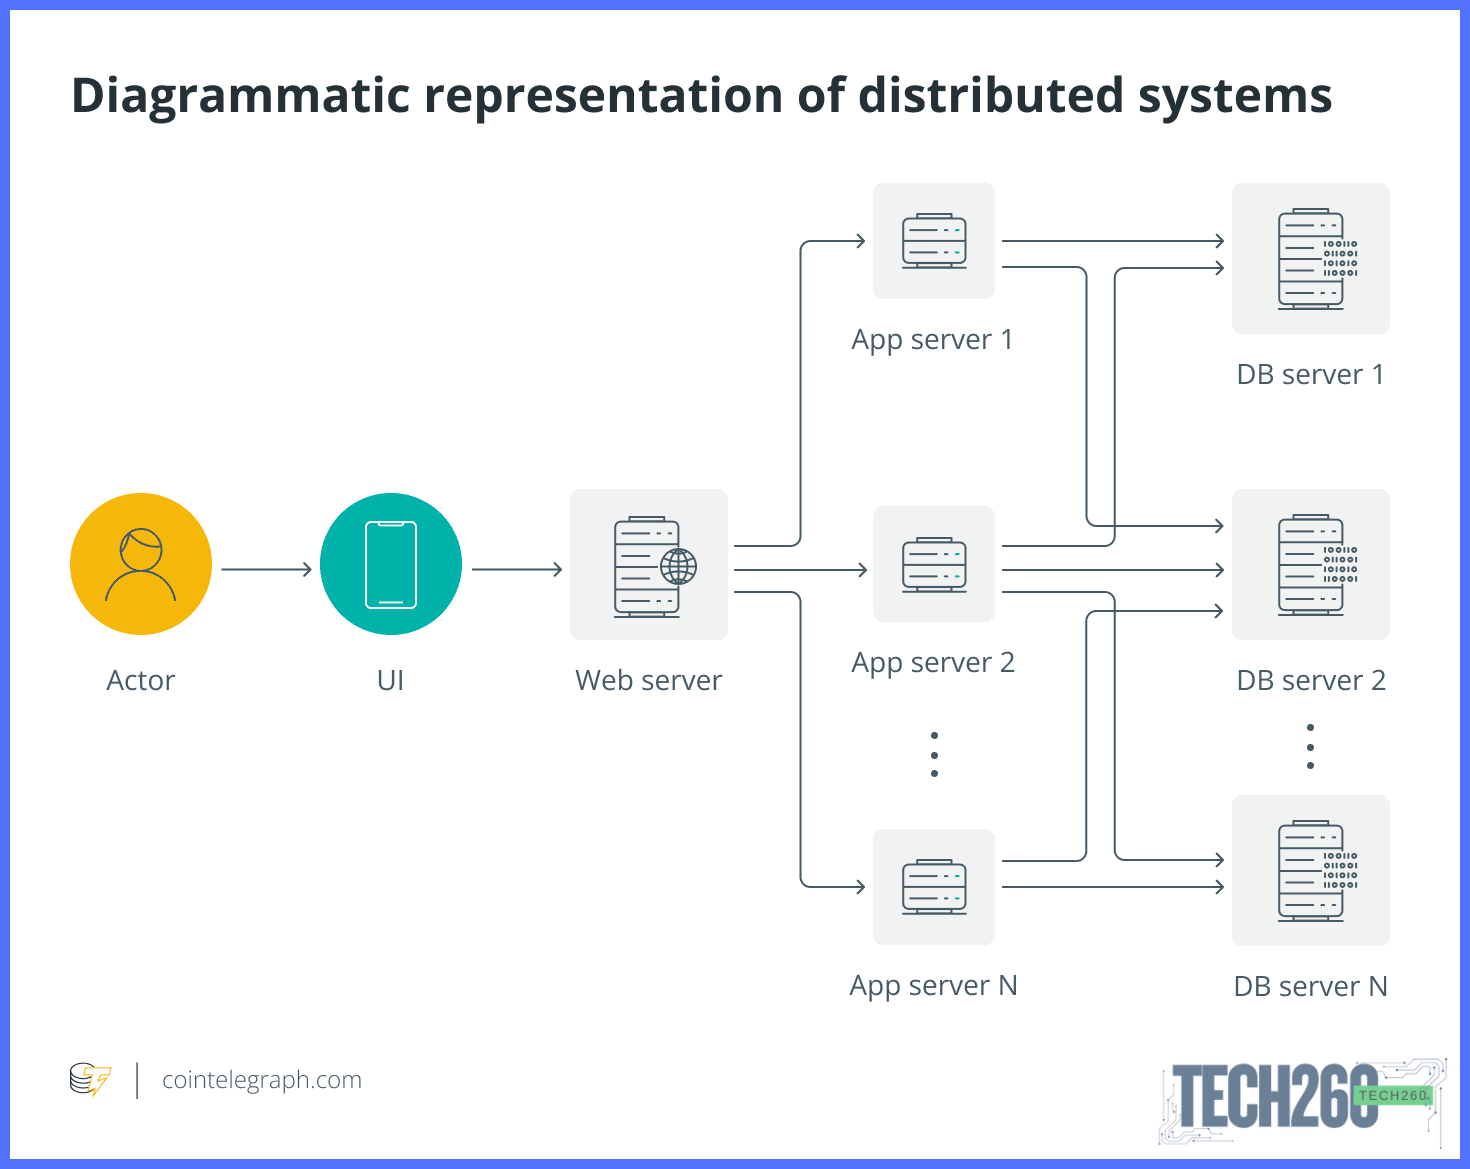
Los mecanismos de replicación y tolerancia a fallos son el núcleo que garantiza la disponibilidad y durabilidad de los datos en un sistema distribuido. Para entender estos sistemas, es esencial saber que replican cada bloque de datos en múltiples nodos físicos (generalmente tres o más copias) ubicados en diferentes racks o zonas de disponibilidad. Si un servidor falla, el sistema redirige automáticamente las solicitudes de lectura/escritura a las réplicas sanas, sin interrupción del servicio. Este proceso se gestiona mediante un maestro de metadatos (como el NameNode en HDFS) que monitorea el estado de cada nodo y coordina la replicación.
Sin embargo, la tolerancia a fallos no se limita a copiar datos. Los sistemas implementan checksums para detectar corrupción silenciosa y replicación proactiva para restaurar el factor de replicación cuando un nodo se recupera. También se usan técnicas como el quorum de escritura (escribir en al menos dos de tres réplicas) para evitar inconsistencias. En entornos multi-nube, la replicación puede ser geográfica, protegiendo contra desastres regionales. Así, al analizar esta tecnología, la respuesta incluye un diseño donde la redundancia y la auto-reparación son obligatorias para ofrecer un servicio confiable.
Escalabilidad horizontal y acceso concurrente desde múltiples ubicaciones
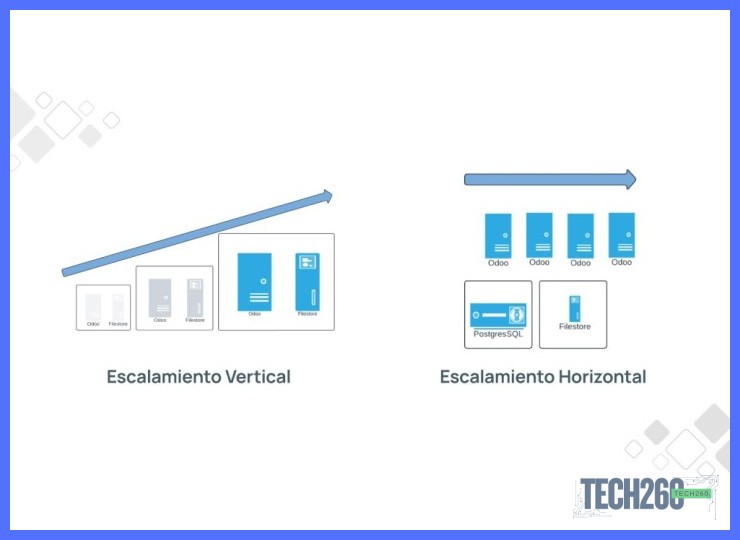
La escalabilidad horizontal en los sistemas de archivos distribuidos en la nube permite agregar más nodos de almacenamiento y procesamiento a medida que crece la demanda, en lugar de depender de un único servidor más potente. Esto responde directamente a la pregunta central: una infraestructura que fragmenta los datos en bloques y los replica entre múltiples servidores, garantizando que el acceso concurrente desde múltiples ubicaciones sea posible sin cuellos de botella. Cada nodo maneja una parte de la carga, lo que permite que cientos o miles de usuarios lean y escriban archivos simultáneamente desde distintas regiones geográficas.
Sin embargo, la concurrencia introduce desafíos de consistencia. Para mantener la integridad de los datos, estos sistemas implementan mecanismos como bloqueos distribuidos o versiones de archivos, que evitan conflictos cuando dos usuarios modifican el mismo bloque al mismo tiempo. La replicación geográfica, por su parte, asegura que una copia del archivo esté cerca del usuario, reduciendo la latencia. Al entender esta tecnología, se comprende que su diseño prioriza la tolerancia a fallos y la elasticidad, sacrificando en ocasiones la coherencia inmediata para priorizar la disponibilidad y el rendimiento en entornos globales.
Comparativa entre Google Cloud Filestore y Amazon EFS
Al evaluar estos sistemas, la comparativa entre Google Cloud Filestore y Amazon EFS revela dos enfoques distintos para almacenamiento compartido. Ambos ofrecen sistemas de archivos NFS totalmente administrados, pero Filestore se destaca por su rendimiento predecible con opciones de IOPS dedicadas, ideal para cargas de trabajo intensivas como HPC o transcodificación. En contraste, Amazon EFS escala automáticamente desde kilobytes a petabytes, siendo más flexible para aplicaciones con patrones de acceso variables, como servidores web o contenedores.
Un matiz clave es el modelo de precios: Filestore cobra por capacidad aprovisionada, lo que garantiza velocidad constante pero puede generar costos fijos. EFS usa un esquema por uso, con clases de almacenamiento como Infrequent Access para reducir gastos en datos poco accedidos. En cuanto a integración, EFS se conecta nativamente con servicios AWS como Lambda o EC2, mientras Filestore optimiza la latencia dentro de Google Cloud, especialmente con GKE y Compute Engine. Para decidir, evalúa si priorizas rendimiento predecible (Filestore) o elasticidad sin gestión de capacidad (EFS). Entender estas diferencias ayuda a elegir según la criticidad de la consistencia y el costo operativo.
Sistemas de archivos distribuidos en la nube: definición, funcionamiento y casos de uso
Lo Que Necesitas Saber
Un sistema de archivos distribuido organiza los datos como una jerarquía de archivos y carpetas accesible mediante rutas, ideal para aplicaciones que requieren compatibilidad con sistemas operativos. En cambio, el almacenamiento en bloques maneja datos en unidades fijas (volúmenes) y el de objetos utiliza identificadores únicos, ofreciendo escalabilidad masiva pero sin estructura jerárquica nativa.
Los retos clave incluyen la latencia de red al acceder a datos remotos, la consistencia de datos entre múltiples nodos replicados y la tolerancia a fallos para evitar pérdidas. Estos problemas se resuelven con técnicas como fragmentación (sharding), replicación síncrona/asíncrona y sistemas de metadatos distribuidos.
¿Qué industria se beneficia más de un sistema de archivos distribuido en la nube?
La industria de big data y analytics es la más beneficiada, ya que requiere escalabilidad horizontal para procesar petabytes de datos no estructurados. También sectores como streaming de video (almacenar archivos grandes) y backup empresarial (alta durabilidad) aprovechan la fragmentación y replicación automáticas de estos sistemas.
Fuentes y recursos de referencia
Cuando hablamos de qué son los sistemas de archivos distribuidos en la nube, nos referimos a infraestructuras que almacenan datos fragmentados en múltiples servidores remotos. Esto permite acceso simultáneo, alta disponibilidad y escalabilidad sin depender de un solo dispositivo físico. Es la base de servicios como Google Drive o Dropbox, optimizando la gestión de información masiva.
Si quieres conocer otros artículos parecidos a Qué son los sistemas de archivos distribuidos en la nube puedes visitar la categoría Software.
Deja una respuesta
Más contenido relacionado